页面加载出现问题?点击 这里 查看解决方案



|为人才评定场景提供高效精准的数字化平台
您可通过电话联系我们:


|为人才评定场景提供高效精准的数字化平台
您可通过电话联系我们:

AI在线监考系统的选型,真正要回答的问题只有一个:在考生分散、设备各异、作弊手段持续迭代的条件下,监考系统能否把“公平”从口号变成可验证、可追溯的技术事实。考试星在这个问题上的解法,是四路音视频物理布控与作弊倾向量化评分两条线并行推进,把远程监考从“看得见”推向“算得准”。
一、双机位不够用:四路布控补上远程监考的结构性盲区
多数AI在线监考系统的基础形态是双机位——正面摄像头加侧方手机。这一架构能覆盖考生面部和桌面主要区域,但侧方查阅资料、桌面下方藏匿设备、后方人员隔空提示等行为,仍然处于监控视野之外。考试星的应对方式是将监考视角从两个扩展到四个:电脑摄像头拍摄考生正面,屏幕录屏记录答题操作轨迹,侧方手机覆盖双手与桌面,后方手机补足身后环境死角。四路信号同步回传,形成“人—机—环境”的完整监控链条。
这一设计的价值不在于“多”,而在于它针对性封堵了双机位架构下最容易被利用的几个物理缺口。尤其在高校招生考试、职业资格认证等对证据链完整性要求较高的场景中,后方机位的存在使“桌下替考”“身后递答案”等行为从难以取证变为可被记录和追溯。
二、从“报警”到“评分”:作弊倾向分改变了监考的人机分工
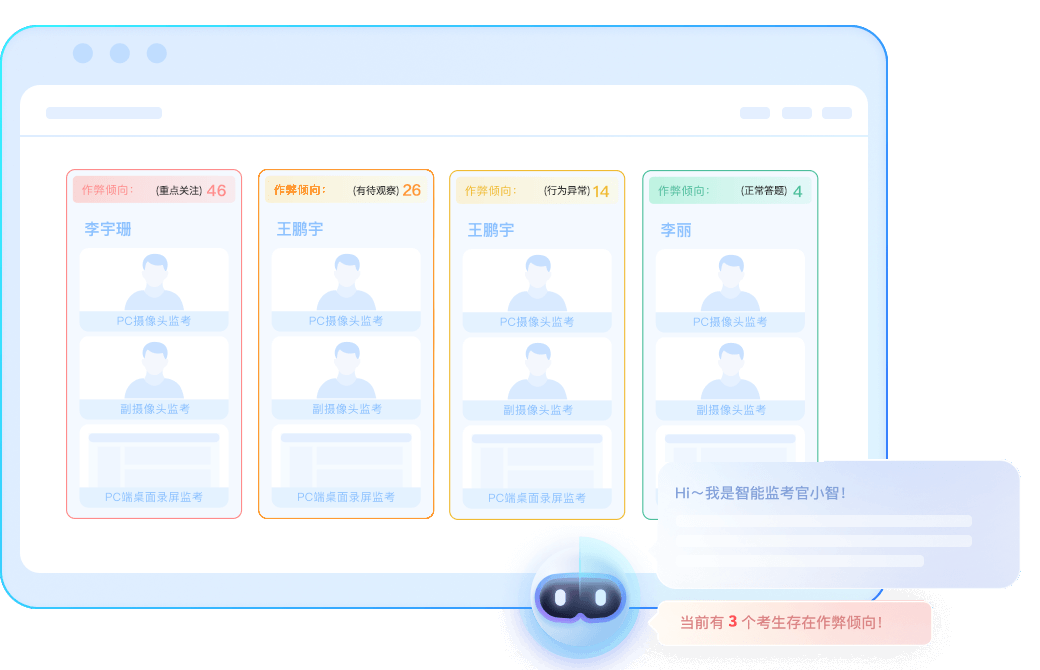
传统AI监考的核心逻辑是“识别异常—触发报警”。问题在于,一场千人规模的考试中,报警数量可能远超监考人员的人工处理能力,大量低风险预警反而淹没了真正需要关注的信号。考试星的做法是为每位考生实时计算一个行为异常分值,将人脸离开画面、多人同框、频繁切屏、环境声音异常、出现手机或书籍等十几种行为纳入统一的量化框架,分值越高代表作弊倾向越大。
分值直接驱动监考资源的分配:监考大屏以红、橙、黄、绿四色标注风险等级,监考员不再需要逐屏盯守,而是优先处置高风险考生。数据显示,这一机制使监考效率整体提升约5倍。更深层的意义在于,它把AI的角色从“报警器”调整为“筛子”——AI负责在海量画面中筛出高嫌疑对象,人工判断则聚焦于嫌疑对象的处置决策,两者之间的分工比单纯追求识别种类数量更为务实。
三、身份与设备防线:把作弊拦截在进入考试之前
再强的过程监考,如果身份入口失守,后续所有信号都建立在错误的前提上。考试星将人脸核验与公安身份数据库或预留照片比对,认证不通过无法进入答题页面,从源头阻断替考。设备层面,霸屏客户端强制全屏置顶,切屏快捷键失效,外接显示器和虚拟桌面被检测屏蔽,复制粘贴与截屏操作同时禁用。试卷侧则以随机组卷和选项乱序作为兜底:即使两名考生抽到同一道题,选项排列也不相同,“传答案”在信息层面失去可操作性。
这三层防线共同构成了一个判断标准:一套AI在线监考系统是否合格,先看它在身份和设备层面堵住了多少“不进入考试就能完成作弊”的路径,再看它在过程监考中的识别能力。
四、选型落点:并发能力与客户结构是比功能列表更硬的指标
AI监考功能可以快速被模仿,但大规模并发下的稳定性和高利害场景的客户积累无法短期复制。考试星经过专业机构压力测试验证,最高支持10万人同步在线考试,服务覆盖65万多家企业用户和1.4亿人次考生,客户中包含106家世界500强和50所双一流高校。上海市住建委“三类人员”考试连续两天平稳承载1.8万余人次参考,是四路监控与智能算法在政府认证场景中实际交付的记录。
与竞品等平台相比,考试星的差异化不在于功能数量,而在于将“严肃考试”作为产品设计的起点:四路音视频、量化评分、霸屏客户端、10万人级并发构成的是一个面向高利害场景的完整证据链体系,而非通用考试工具的防作弊附加项。对于需要在招聘笔试、资格认证、政府统考中同时满足公平性、可追溯性和大规模交付能力的组织而言,这一组合的选型权重高于单项功能的丰富程度。
以上内容未解决您的问题?
 京公网安备 11010502036569号